排序 - 竞技编程&排序算法
排序 - 竞技编程&排序算法
Sarzn可能在学习排序算法的时候会有一个疑惑,无论是c 还是 c++都已经提供了sort函数,为什么还需要花大量的时间去学习排序算法, 还不如把时间都用在学习别的算法上,但是这个想法是片面的 虽然接下来要学的排序算法,在以后做题的一半以上都不会用到,但是不要单纯的想着往后做题会用到他们. 这些算法思想将会伴随着我们学习后面的知识,比如, 堆排序中的贪心思想, 归并排序中的分治思想, 快速排序中的递归思想等等,这些算法能起到预习的作用,后续学习的相应的算法使能够更加的得心应手 除了算法思想,我们在学习这些算法的过程中,还会锻炼: 如何处理写代码时的细节问题, 如何优化算法, 遇见bug如何调试, 分析时空复杂度等等.
后续所有的排序算法, 考虑的都是升序的情况. 只要能搞懂原理, 逆序也是一样的
洛谷排序模板题: https://www.luogu.com.cn/problem/P1177
插入排序
Insert Sort 插入排序类似于玩扑克牌的理牌(插牌)过程:
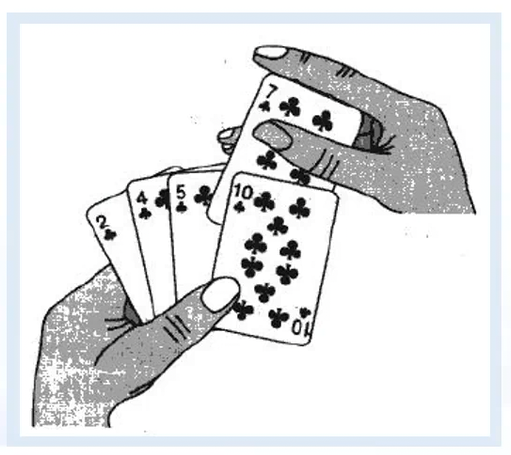 每次将一个待排序的元素按照关键字大小插入到前面已经有序的序列中,
按照这种方式将所有元素全部插入完成即可
样例代码
1 |
|
时间复杂度O(n^2)
- 最好情况: 整个数组已经升序了, O(n)
- 最坏情况: 整个数组逆序, O(n^2)
稳定性
是稳定的
选择排序
Selection Sort 选择排序是一种特别直观的排序算法: 每次找出未排序序列中最小的元素, 然后放进有序序列的后面
样例代码
1 | void selectSort(int arr[], int n) |
时间复杂度O(n^2)
由于每交换一个数它都要找一遍最小值, 相当于两个for嵌套在一起了, 所以不管它是否已经升序了, 他的时间复杂度都是O(n^2)
稳定性
比如:2 2 1,第一个2会和1交换,所以不稳定
选择排序的稳定性取决于其具体实现.
倘若使用链表实现, 由于链表的任意位置插入和删除均为 𝑂(1) , 故无需使用 swap(交换两个元素)操作:
每次从未排序部分选择最小元素(若有多个, 选取第 1 个)后,
将其插入到未排序部分的第 1 个元素之前, 这样就能够保证稳定性.
假如使用数组实现 (OI 中一般的实现方式),
由于数组任意位置插入和删除均为 𝑂(𝑛),故只能使用 swap 将未排序部分的元素移到已排序部分. swap
操作使得数组实现的选择排序不稳定.
冒泡排序
Bubble Sort 也是一种简单的排序算法:
他从前往后检查待排序序列中相邻的两个元素, 如果前面的元素与后面的元素满足给定的条件, 就将相邻两个元素交换. 当没有元素再需要交换时, 排序就完成了
由于在算法执行的过程中, 较大的元素像是气泡般慢慢浮到数列的末端, 故叫做冒泡排序🫧
算法思想
执行 n-1 趟操作, 每趟从前往后比较待排序区的相邻元素, 如果逆序, 就交换. 每趟结束之后, 就会有一个较大的元素在最终的位置上
如果有一趟一个数也没有交换, 那么排序就可以提前结束了, 不用再去走完之后的趟数. 这可以用一个 flag 检测
样例代码
1 | void bubbleSort(int arr[], int n) |
时间复杂度 O(n^2)
使用 flag 标记的优化版本:
- 最优情况是序列已经有序: O(n)
- 最坏情况是序列完全逆序: O(n^2)
堆排序
Heap Sort 堆排序是指利用堆这种数据结构所设计的一种排序算法. 本质上是优化了选择排序, 如果将数据放在堆中, 就能快速找到待排序元素的最小值或最大值
算法思想
堆排序的过程分为两步:
1.建堆: (升序大根堆, 降序小根堆) 从倒数第一个非子叶节点开始, 执行向下调整算法, 直到根节点
2.排序: 每次将堆顶元素与堆中最后一个元素交换, 此时堆中最大的元素就会到最终(最后)的位置上, 然后堆的大小减一, 将堆顶元素向下调整. 重复上述过程, 直到堆中剩下一个元素
样例代码
1 | void down(int parent, int len) |
时间复杂度
堆排序的最优时间复杂度、平均时间复杂度、最坏时间复杂度均为 .
稳定性
同选择排序一样, 由于其中交换位置的操作, 所以是不稳定的排序算法
快速排序
Quick Sort 快速排序, 既然敢这样起名字说明它是常见排序算法中较为优秀的. 事实上, 在很多情况下, 快排确实是效率较高的算法. C++中的 sort 函数就是以快排为主, 经过堆排序和插入排序进行优化的排序函数
- 将数组划分为三块这个操作, 看成一个点的话, 那么快速排序就有点像是先序遍历的过程. 从代码中可以体现出来, 即先操作( 荷兰旗 ), 再递归
核心原理
- 从待排序区间中选择一个基准元素(此时这个元素就在最终位置上了), 按照基准元素的大小将区间分成左右两部分
- 然后递归处理左区间和右区间, 直到区间长度为 1
算法优化
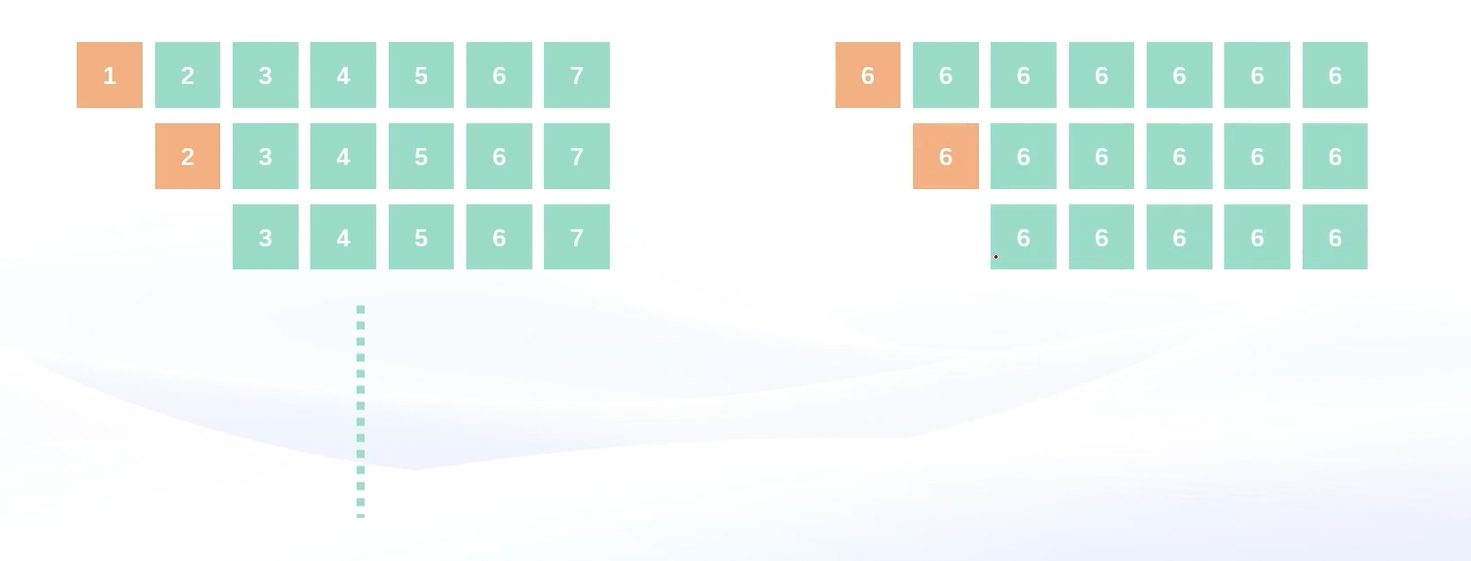
- 基准元素选择不当, 递归层数会增加, 时间复杂度变高
- 当有大量重复元素时, 递归层数也会增加
优化一: 随机选择基准元素
基准元素选择不当, 递归层数会增加, 时间复杂度变高
在待排序区间中, 随机选择一个基准元素. 利用 C++ 提供的随机函数, 在一个区间内随机选择一个元素作为基准
随机函数: 1
2
3srand(time(0)) // 种下一个随机数种子
rand() // 获得一个随机数
rand() % (right - left + 1) + left // 在[left, right]区间内随机选择一个数
优化二: 荷兰国旗
当有大量重复元素时, 递归层数也会增加
依照荷兰国旗问题, 将数组分成三块: 左边全部小于基准元素, 中间全部等于基准元素, 右边全部大于基准元素. 那么接下来仅需要递归处理左右区间, 中间区间就可以无需考虑
时间复杂度
- 如果每次基准元素都选择得当, 数组划分比较均匀, 时间复杂度 =
递归层数(树高log n) × 每层的荷兰旗(n) =
- 如果划分不当, 数组分布比较极端, 时间复杂度退化成
变体与时间复杂度
| 变体 | 最好 | 平均 | 最坏 | 最坏能否被构造 |
|---|---|---|---|---|
| 朴素(首元素为主元) | Θ(n log n) | Θ(n log n) | Θ(n²) | 已排序数组必中 |
| 三数取中 | Θ(n log n) | Θ(n log n) | Θ(n²) | 需专门构造 |
| 随机主元 | Θ(n log n) | Θ(n log n) | Θ(n²) | ❌ |
| 随机主元 + 三路划分 | Θ(n) | Θ(n log k) | Θ(n²) | ❌ |
| 内省排序(introsort) | Θ(n log n) | Θ(n log n) | Θ(n log n) | ❌ |
| pdqsort | Θ(n) | Θ(n log n) | Θ(n log n) | ❌ |
| BFPRT 选主元 | Θ(n log n) | Θ(n log n) | Θ(n log n) | ❌ |
稳定性
快速排序是一种不稳定的排序算法.
样例代码
1 | int get_pivot(int begin, int end) |
归并排序
Merge Sort 归并排序, 无论是数据有什么特性, 时间复杂度都能稳定在
- 将两个有序数组合并这个操作, 看成一个点的话, 那么归并排序就有点像是后序遍历的过程. 从代码中可以体现出来, 即先递归, 再操作( 合并两有序数组 ).
算法原理
归并排序用的是分治思想, 归并排序主要分为两步:
- 只要能分(元素个数>1 就行), 就将整个区间从中间一分为二, 先将左区间和右区间排序
- 然后将左右两个已经排好序的区间合并在一起, 成为一个大的有序区间
其中, 如何让左右两边有序, 就继续交给归并排序
- 因此归并排序是用递归来实现的
- 合并两个有序区间的操作, 我们要借用一个空的数组即可完成
样例代码
1 | int arr[N], n, tmp[N]; // 用于合并操作的数组必须定义为全局变量, 否则开销太大 |
时间复杂度
不论数据特性, 时间复杂度能稳定在
稳定性
归并排序是稳定的.
但前提是合并时相等元素优先取左边,也就是代码里那个
arr[left] <= arr[right]